

Les modèles de LLM
Sans modèle, MIA ne répond à personne. L’administrateur enregistre les clés des éditeurs d’IA, active les modèles à proposer, désigne le modèle par défaut et celui de secours, puis vérifie que tout répond — depuis Administration → Modèles IA.
À quoi ça sert
Section intitulée « À quoi ça sert »À donner aux utilisateurs les bons moteurs, au bon prix : un modèle économique pour l’usage courant, un modèle puissant pour les analyses, un modèle de secours quand un éditeur tombe. Le choix se fait une fois ; les groupes décident ensuite qui a droit à quoi.
Comment ça marche
Section intitulée « Comment ça marche »Trois étages, dans cet ordre. Un modèle n’est proposé à un utilisateur que si :
- la clé API de son éditeur est enregistrée ;
- le modèle est activé ;
- l’un des groupes de l’utilisateur l’autorise — ou aucun groupe n’a de liste, selon les règles de Organiser les groupes.
Le catalogue. Les modèles cloud proposés à l’activation viennent d’un catalogue livré avec MIA,
qui décrit pour chacun ses capacités, ses limites et son tarif public. Il évolue avec les versions de
MIA ; on n’y ajoute pas de modèle à la main. Seul le LLM local — un serveur  Ollama, LM Studio ou
Jan — se déclare librement.
Éditeurs pris en charge :  ChatGPT (OpenAI),
 Claude (Anthropic),
 Mistral, Perplexity,
 Gemini
(Google), DeepSeek, Kimi (Moonshot), GLM (Z.ai), et un LLM local compatible OpenAI.
Ce que chaque éditeur permet. Toutes les capacités ne sont pas partout :
| Capacité | Disponible avec |
|---|---|
| Connecteurs, et outils appelés par un assistant | Tous les éditeurs sauf Perplexity ; quelques modèles en sont exclus (leur fiche le dit), le LLM local seulement si vous le déclarez capable |
| Recherche Internet | OpenAI, Anthropic, Mistral, Gemini, Perplexity |
| Recherche Internet et outils dans la même réponse | OpenAI, Anthropic, Gemini ; avec Mistral, les outils engagés passent avant la recherche |
| Images et PDF joints | Les modèles marqués vision et fichiers ; ceux marqués vision seulement (DeepSeek, certains modèles GLM et Kimi) lisent les images mais pas les PDF ; le LLM local lit le texte seul |
Le modèle par défaut sert aux nouvelles conversations, à l’assistant d’aide, au découpage des documents des bases de connaissances et à l’aide à la rédaction des consignes d’assistant.
Les connecteurs sur tous les éditeurs. DeepSeek, Kimi, GLM, Mistral, Gemini et le LLM local
pilotent eux aussi les connecteurs et les outils des assistants. Restent à l’écart : Perplexity (son
API n’en offre pas) et les modèles Gemini 2.5 (ils ne savent pas chercher sur Internet en même
temps). Avec Mistral, quand un connecteur ou un outil d’assistant est engagé, la recherche
Internet est mise de côté pour cette réponse, et la réponse le dit.
Le modèle de secours prend le relais quand un modèle échoue avant son premier mot — panne, surcharge, saturation, délai dépassé, ou compte de l’éditeur sans crédit. Il garde les connecteurs et les outils s’il sait s’en servir, ne reprend jamais une réponse où une action a déjà été menée, et n’est pas limité par les groupes.
Quand un modèle échoue, l’utilisateur lit un encadré dont le titre nomme la cause — crédit épuisé chez l’éditeur, conversation trop longue, modèle retiré… — et une réponse coupée en route se termine par une ligne qui dit pourquoi. Certains de ces encadrés appellent un geste de votre part : voir Réagir à une erreur de modèle.
Refus et conditions d’accès. Certains modèles — leur colonne Limites, dans Modèles activés, l’indique — déclinent des sujets sensibles, ou ne sont ouverts qu’aux organisations qui conservent les données chez leur éditeur. Dans les deux cas, MIA fait reprendre la demande par un autre modèle du même éditeur, fixé par le catalogue, sans passer par le modèle de secours ; la conversation le signale, et chaque modèle est décompté à son tarif. Les tests, eux, interrogent le modèle seul : voir Tester les modèles.
Configurer
Section intitulée « Configurer »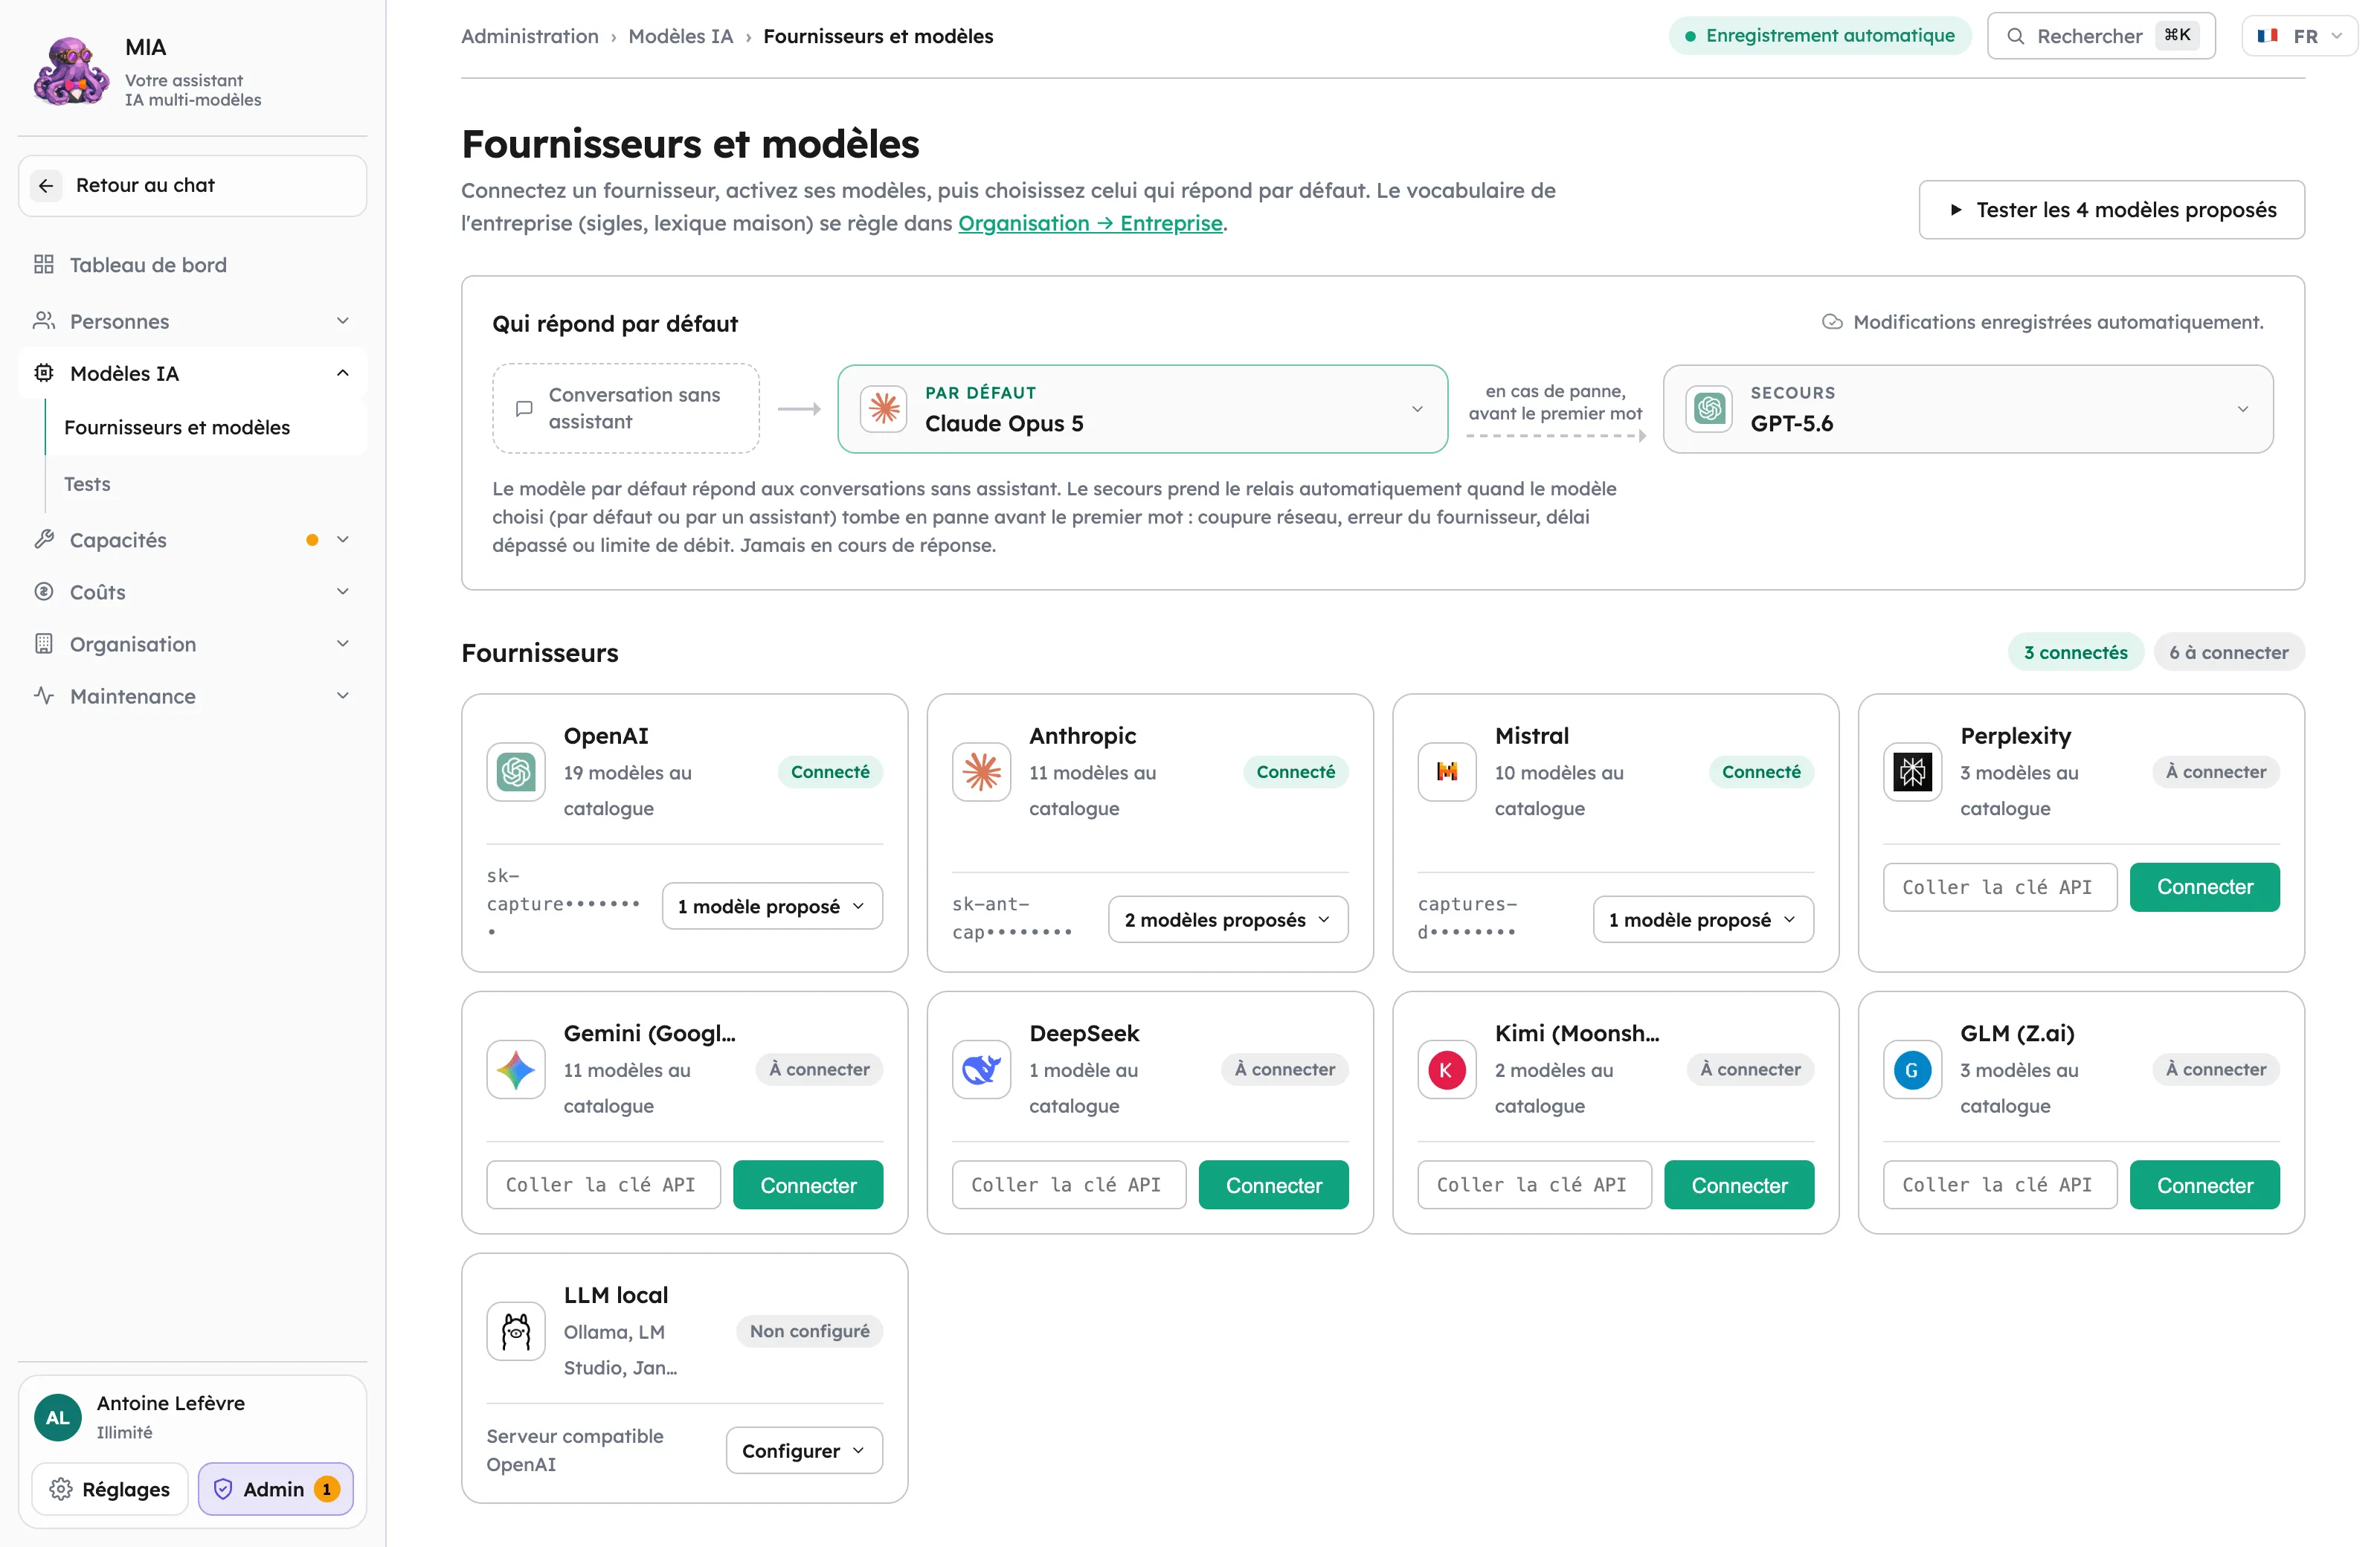
| Réglage | Où | Effet | Page |
|---|---|---|---|
| Clés des éditeurs, LLM local | Modèles IA → Fournisseurs et modèles | Rend un éditeur utilisable | Enregistrer les clés API |
| Activation des modèles | Modèles IA → Fournisseurs et modèles | Les modèles proposables | Activer les modèles |
| LLM par défaut, LLM de secours | Modèles IA → Fournisseurs et modèles, carte Qui répond par défaut | Le démarrage, la continuité | Régler le comportement par défaut |
| Vocabulaire de l’entreprise | Organisation → Entreprise | Le jargon maison | Présenter l’entreprise |
| Vérification de chaque modèle | Modèles IA → Tests | La preuve que tout répond | Tester les modèles |
| Pannes et refus d’un modèle | Dans les conversations, encadré ⚠️ | Ce que lit l’utilisateur, ce que vous avez à faire | Réagir à une erreur de modèle |
| Modèles par groupe | Personnes → Groupes → Droits d’accès → LLMs | Qui a droit à quoi | Organiser les groupes |
| Tarif de chaque modèle | Tarifs & crédits | Le coût en crédits, et le repère € du chat | Régler les crédits |
Exemples de configuration
Section intitulée « Exemples de configuration »Une instance minimale, bien réglée. Clés Anthropic et Mistral ; trois modèles activés — un
économique, un polyvalent, un puissant ; LLM par défaut = le polyvalent ; LLM de secours =
un modèle de l’autre éditeur, pour survivre à une panne d’un fournisseur. Tests lancés.
Des modèles puissants réservés. Le groupe ★ Par défaut n’a que le modèle économique et le polyvalent ; le groupe Juridique a en plus le modèle puissant. Pour un usage ponctuel, un assistant qui impose le modèle puissant suffit : il échappe aux listes des groupes.
Un modèle hébergé chez vous. Un serveur Ollama joignable depuis MIA — ou le cloud Ollama, avec
son adresse et sa clé API —, déclaré comme LLM local : il apparaît dans le groupe Local du
sélecteur, gratuit en crédits, en texte seul, sans recherche Internet ; les connecteurs seulement si
vous le déclarez capable d’appeler des outils.
Un éditeur peut fermer ou arrêter un modèle. Un modèle qu’un éditeur réserve à ses clients existants le dit sous son nom, dans le panneau de son fournisseur (Fournisseurs et modèles). Un arrêt annoncé porte le badge Arrêt le … et le remplaçant désigné ; une pastille le rappelle tant que le modèle est activé. Le jour de l’arrêt, MIA le retire du sélecteur, et ce qui l’utilisait — conversations, assistants, modèle par défaut — passe sur le modèle par défaut : voir Activer les modèles.
Préparer un changement de génération. Un éditeur annonce l’arrêt d’un modèle (badge Arrêt le …) : activez le remplaçant désigné, cochez-le dans les groupes, basculez le défaut et les assistants qui imposaient l’ancien, puis retirez l’ancien — avant la date, pour choisir vous-même ce qui prend la relève.
Vérifier que tout fonctionne
Section intitulée « Vérifier que tout fonctionne »- Tests → Lancer tous les tests : chaque modèle activé doit répondre.
- Qui répond par défaut : les badges Par défaut et Secours apparaissent dans le panneau de leur fournisseur.
- Avec un compte non administrateur du groupe ★ Par défaut : le sélecteur montre les modèles attendus, et une question reçoit une réponse.
Voir aussi
Section intitulée « Voir aussi »- Les modèles de LLM, côté utilisateur
- Les utilisateurs et les accès — les listes de modèles par groupe
- La gestion des crédits — les tarifs
- Les assistants — les modèles qu’ils imposent